™
全部模型与产品
-
Muse Wonder vs GPT-6:两家旗舰一周内相遇
为什么重要这是 Meta 首次以付费 API 形式推出前沿闭源模型,与覆盖 12 亿周活用户的 GPT-6 在同一周相遇。
-
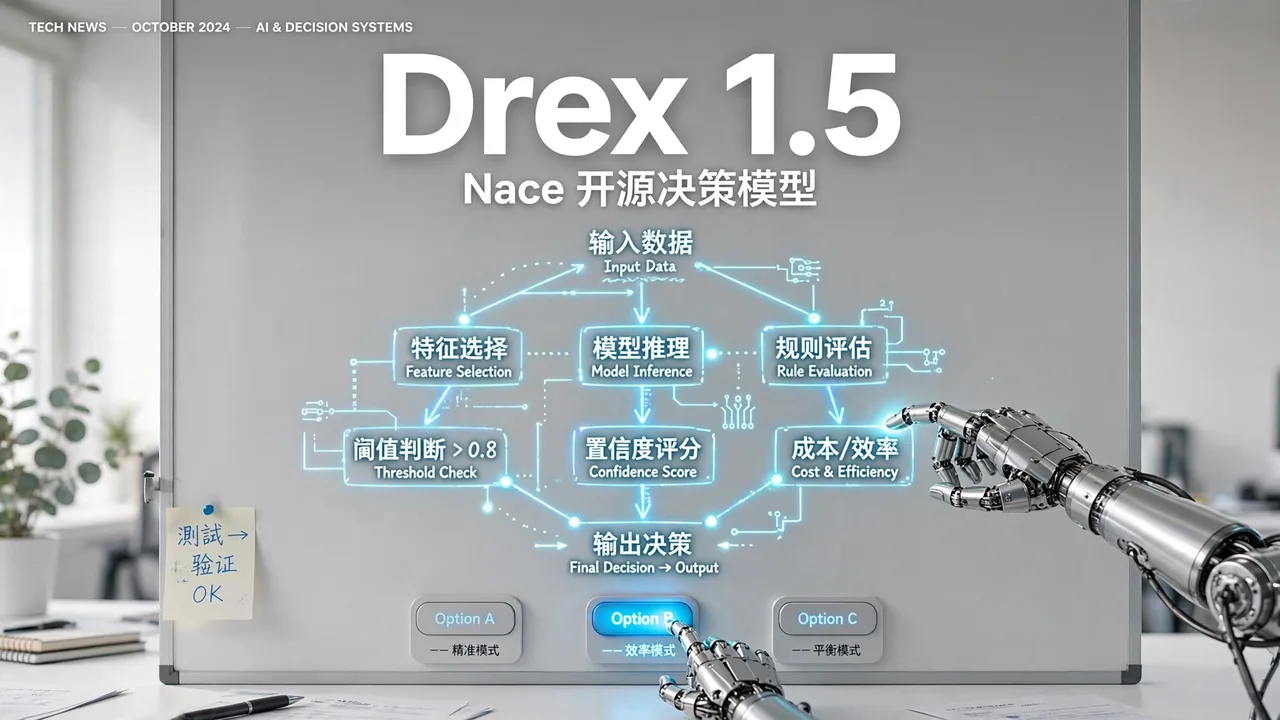
实测 Drex 1.5:9B 决策模型,选项打分不生成文本
为什么重要决策模型赛道第一次出现与闭源 Jev 同档的开源权重,智能体判分环节有了本地可跑的选项。
-
实测 OpenAI Decisions API:判分不写字,分类快约十倍
为什么重要分类、审核、路由这类判分工作第一次有了专用端点,不用再从聊天模型里正则抠答案。
-
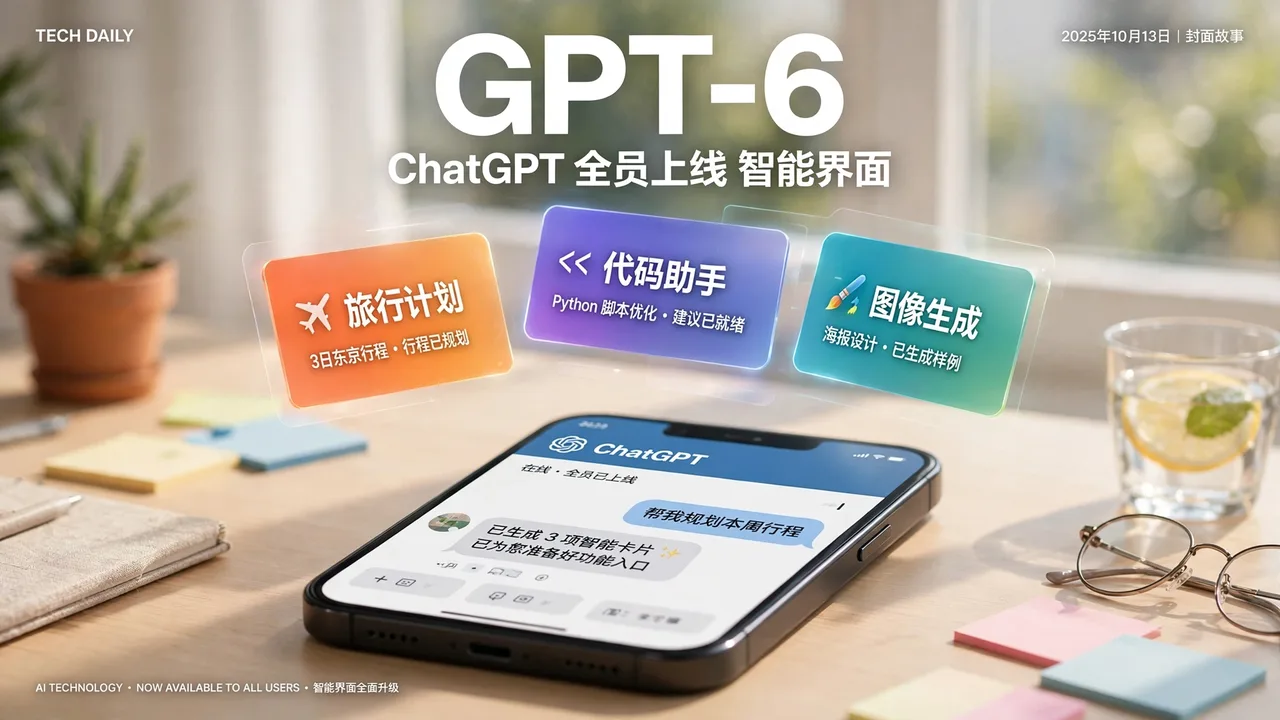
实测 GPT-6:智能界面上线 ChatGPT,搜索类回答快 44%
为什么重要ChatGPT 每周 12 亿用户(OpenAI 数据)的默认交互从纯文本变成模型自选的可交互组件。
-
实测 Meta Muse Wonder:前沿智能体模型,记忆与专注双引擎
为什么重要这是 Meta 第一个在独立指数上接近 Claude Opus 5.5(58 分)与 GPT-6 Astra(53 分)的模型。
-
阿里 Qwen 发布 QwenGyre:面向超长时程智能体的弹性强化学习框架
为什么重要论文称在旗舰模型 Qwen 3.8 2.4T 上,48 步训练后 NL2RepoBench 通过率从 52.5% 升至 58.5%,端到端训练加速最高 1.85 倍。
-
Meta 发布 Muse Wonder 与 Muse Wonder Full:自称达到 AI 前沿的旗舰模型
为什么重要这是 Meta 首次推出自称达到前沿水平的模型,也是其 AI 部门重组 14 个月后最重要的产品发布。
-
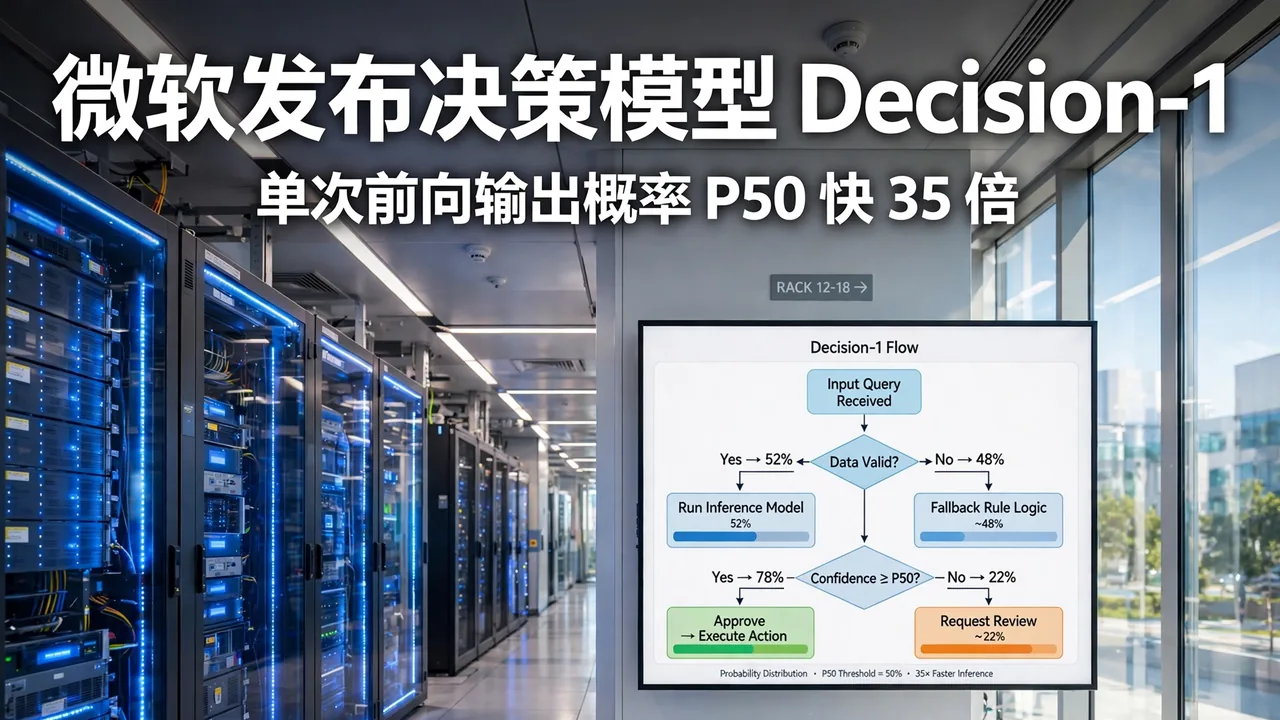
微软发布 Decision-1 决策模型:不生成文本,只输出校准概率
为什么重要Decision-1 不输出文本,单次前向即给出校准概率,用于智能体工作流中的决策打分;据称 P50 快 35 倍、价格便宜 58%。
-
谷歌内测 Gemini 4「Carbon」:员工称代码能力直追 Claude Opus 5.5
为什么重要测试员工称 Carbon 编程表现堪比 Claude Opus 5.5;早期 Argon 版本曾被员工反馈部分编程任务落后竞品,谷歌未公布 Carbon 基准成绩。
-
实测 Perplexity pplx-embed-v2-late:0.6B 小模型,查 9B 大索引
为什么重要两个尺寸共享同一向量空间,索引可由 9B 离线建、查询由 0.6B 在线跑,查询成本按小模型计。